Un modelo, cuatro harness: una revisión de código en busca de vulnerabilidades
Comparación de pi, DeepSeek Harness (dsh), OpenCode y fx de Vercel con el mismo modelo, el mismo prompt y la misma base de código.
La pregunta
La gente compara modelos todo el tiempo en ciberseguridad pero el harness casi nunca, aunque el harness decide lo que el modelo puede hacer de verdad: qué herramientas recibe, cuántas veces itera, cómo empaqueta el contexto, cómo queda escrito el resultado. Por eso quise experimentar y buscar el mejor harness para buscar vulnerabilidades en código, cambié el harness cuatro veces y medí qué se movía: volumen, precisión, costo y tiempo.
Metodología
Qué se comparó
| harness | versión |
|---|---|
| pi | 1.5.0 |
| DeepSeek Harness (dsh) | 0.2.1-rc.5 |
| OpenCode | v2.2.5 |
| fx (Vercel Labs) | 0.0.16 |
Qué se mantuvo fijo
- Modelo:
deepseek-v4.1-flash:1017enhttps://ollama.com/v1. - Prompt: Encontrar defectos críticos y altos, reportar la línea de origen, la cadena de fuente a sink, los requisitos del atacante y el impacto, calidad antes que cantidad.
- Objetivo: una aplicación Node.js grande, con una copia aislada del mismo árbol por ejecución.
- Sandbox: una sola imagen Docker, un contenedor por harness, usuario sin privilegios. Salida a red permitida para alcanzar el endpoint del modelo.
- Límites: 28 minutos de timeout por celda (límite del experimento, no del harness), 3 harness en paralelo.
Cómo se corrió el benchmark
Fue algo muy casero, en un docker separada para cada harness se abrió cada uno con el mismo prompt, se ejecutó el prompt en 5 corridas diferentes por cada harness, luego se promediaba findings, costos, tiempo de cada harness
Filtro de verificación
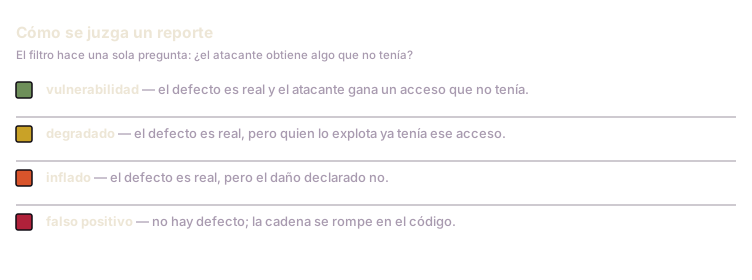
Un defecto reportado es una afirmación hasta que alguien intenta romperla. Agrupé los reportes por causa raíz y le entregué cada uno a un revisor de solo lectura al que le pedí refutarlo, con una lista fija de preguntas: con qué acceso empieza el atacante, cómo llega cada requisito previo, si ese requisito ya concede el mismo poder, si se cruza una frontera de privilegio real, y si el impacto se demostró o solo se supuso. Lo dudoso contó como refutado.
Resultados
Conclusiones
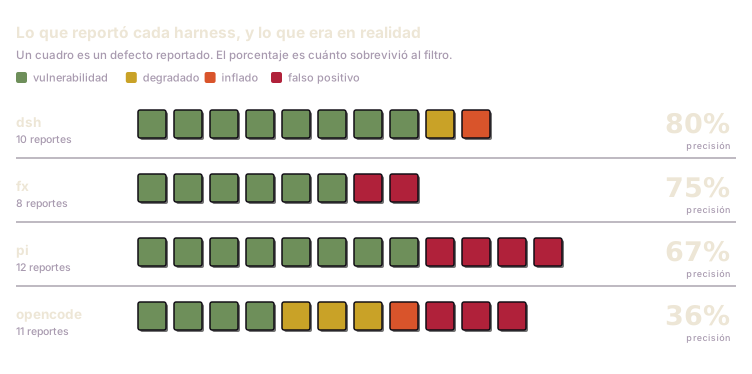
Con el mismo modelo, el mismo prompt y la misma base de código, la precisión fue del 80% en el mejor harness y del 36% en el peor. El harness no es algo que debamos obviar actualmente: decide qué se encuentra y cuánto ruido hay que descartar después.
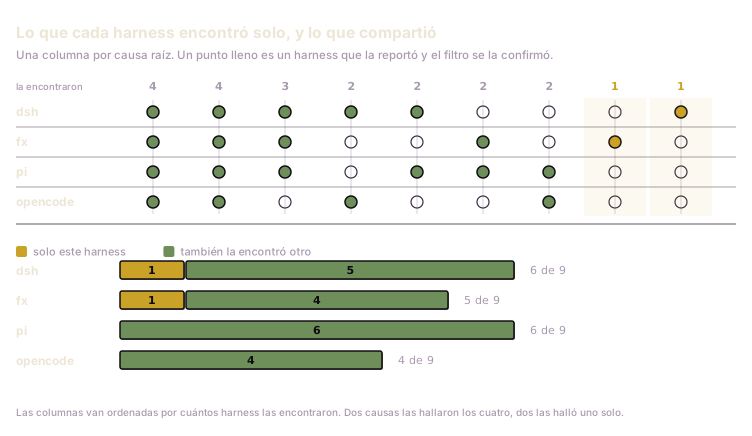
dsh gana en calidad. Fue el único que no produjo ningún falso positivo: 10 reportes, 8 se sostuvieron, uno quedó degradado y otro con la severidad inflada, ninguno se cayó. También fue el que más causas distintas cubrió, 6 de las 9, las mismas que pi, y uno de los dos harness que encontraron una causa que a los demás se les pasó. Para deepseek-v4.1-flash:1017, DeepSeek Harness es el que mejor rinde.
Ese resultado hay que leerlo con una advertencia: el modelo que corrí fue optimizado por DeepSeek para su propio harness: lo dice el anuncio del release. Así que dsh corrió con el harness para el que fue entrenado y los otros tres no. Parte de la ventaja es del modelo, no del harness.
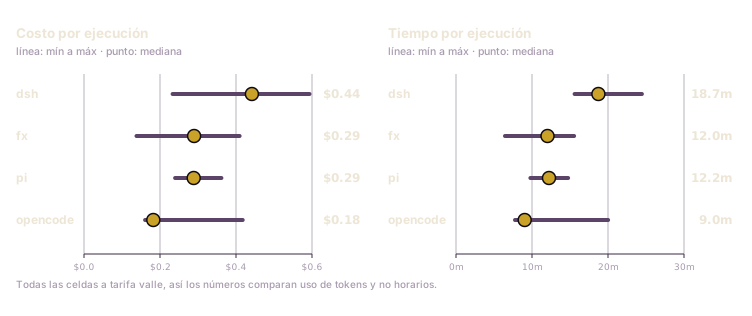
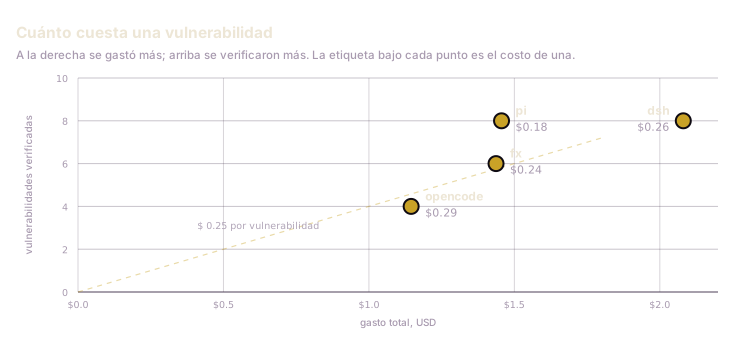
pi gana en precio. $0.29 por ejecución y $0.18 por vulnerabilidad verificada, contra $0.44 y $0.26 de dsh. Y no encuentra menos: pi y dsh empatan en hallazgos reales (8) y en causas cubiertas (6 de 9). Lo único que los separa es el ruido, 4 reportes refutados de 12 contra ninguno de 10.
| pi | dsh | |
|---|---|---|
| costo mediano por ejecución | $0.29 | $0.44 |
| costo por vulnerabilidad | $0.18 | $0.26 |
| duración mediana | 12 min | 19 min |
| hallazgos reales | 8 | 8 |
| causas distintas, de 9 | 6 | 6 |
| reportes refutados | 4 de 12 | 0 de 10 |
A pi le faltan tres causas. Una la encontraron también dsh y OpenCode, otra solo fx y otra solo dsh. No falla en el núcleo que todos comparten: se queda corto en los bordes.
Los otros dos quedan fuera de la final. fx perdió 3 de sus 8 celdas y aun así llegó al 75% de precisión con 5 causas: rinde cuando termina, y no siempre termina. OpenCode es el más barato por ejecución y el más caro por hallazgo, con 36% de precisión y 4 causas.
Mi elección personal es pi, por costo y por eficiencia. Con la misma cobertura y menos gasto por hallazgo, la brecha que le queda es de precisión, y la precisión se sube sin cambiar de harness: un AGENTS.md con el criterio de reporte y skills con los flujos que este tipo de revisión repite. dsh trae parte de ese criterio metido en los pesos del modelo; pi lo recibe escrito en el repositorio.
Esa parte no está medida. Aquí comparé cuatro harness desnudos, sin AGENTS.md ni skills, con cinco ejecuciones por harness. Eso alcanza para ver la diferencia que existe, no para afirmar cuánto se cierra al añadir instrucciones. Es la siguiente medición, no un resultado.
Mi conclusión final es:
El harness puede inferir bastante en qué se encuentra, por eso ya no hay que obviarlo, hay que investigar y usar el que mejor se acople a tu workflow